Manual de Burp Suite Community Edition
Capítulo 18 · Race conditions
Serie: Burp Suite desde cero | unfantasmaenelsistema.com
Todo lo anterior asumía que las peticiones llegan de una en una. Este capítulo pregunta qué pasa cuando eso deja de ser verdad -cuando dos peticiones legítimas llegan al servidor casi al mismo instante, y el código no estaba preparado para esa coincidencia. Es un tipo de fallo distinto a todos los anteriores: no está en un campo mal validado, está en el tiempo.
Qué aprenderás en este capítulo
Qué es una race condition (TOCTOU) y por qué es un fallo de tiempo, no de datos · La función de Burp Community pensada exactamente para esto: enviar un grupo de peticiones en paralelo · Dos pruebas reales contra Juice Shop que NO encontraron nada explotable -y por qué eso también hay que saber reconocerlo · Una lección de investigación tan importante como cualquier hallazgo: cómo confirmar que algo sospechoso es de verdad una race condition antes de darlo por bueno
1. Qué es una race condition
TOCTOU -Time Of Check To Time Of Use- describe cualquier código que primero COMPRUEBA algo y después ACTÚA según lo que comprobó, con un hueco de tiempo entre medias. Si ese hueco existe, dos peticiones que lleguen dentro de la misma ventana pueden comprobar lo mismo -por ejemplo, "¿esta cuenta ya existe?", "¿queda saldo?", "¿este cupón ya se usó?"- y las dos reciben la misma respuesta a la comprobación, aunque solo una de ellas debería haber podido actuar.
2. La herramienta de Burp para esto
Probar una race condition a mano -clicar dos veces muy rápido- casi nunca lo consigue: la latencia de red normal ya separa las peticiones más de lo que dura la ventana vulnerable. Burp Community trae una función pensada exactamente para cerrar ese hueco: agrupar varias pestañas de Repeater con la misma petición y mandarlas todas a la vez.
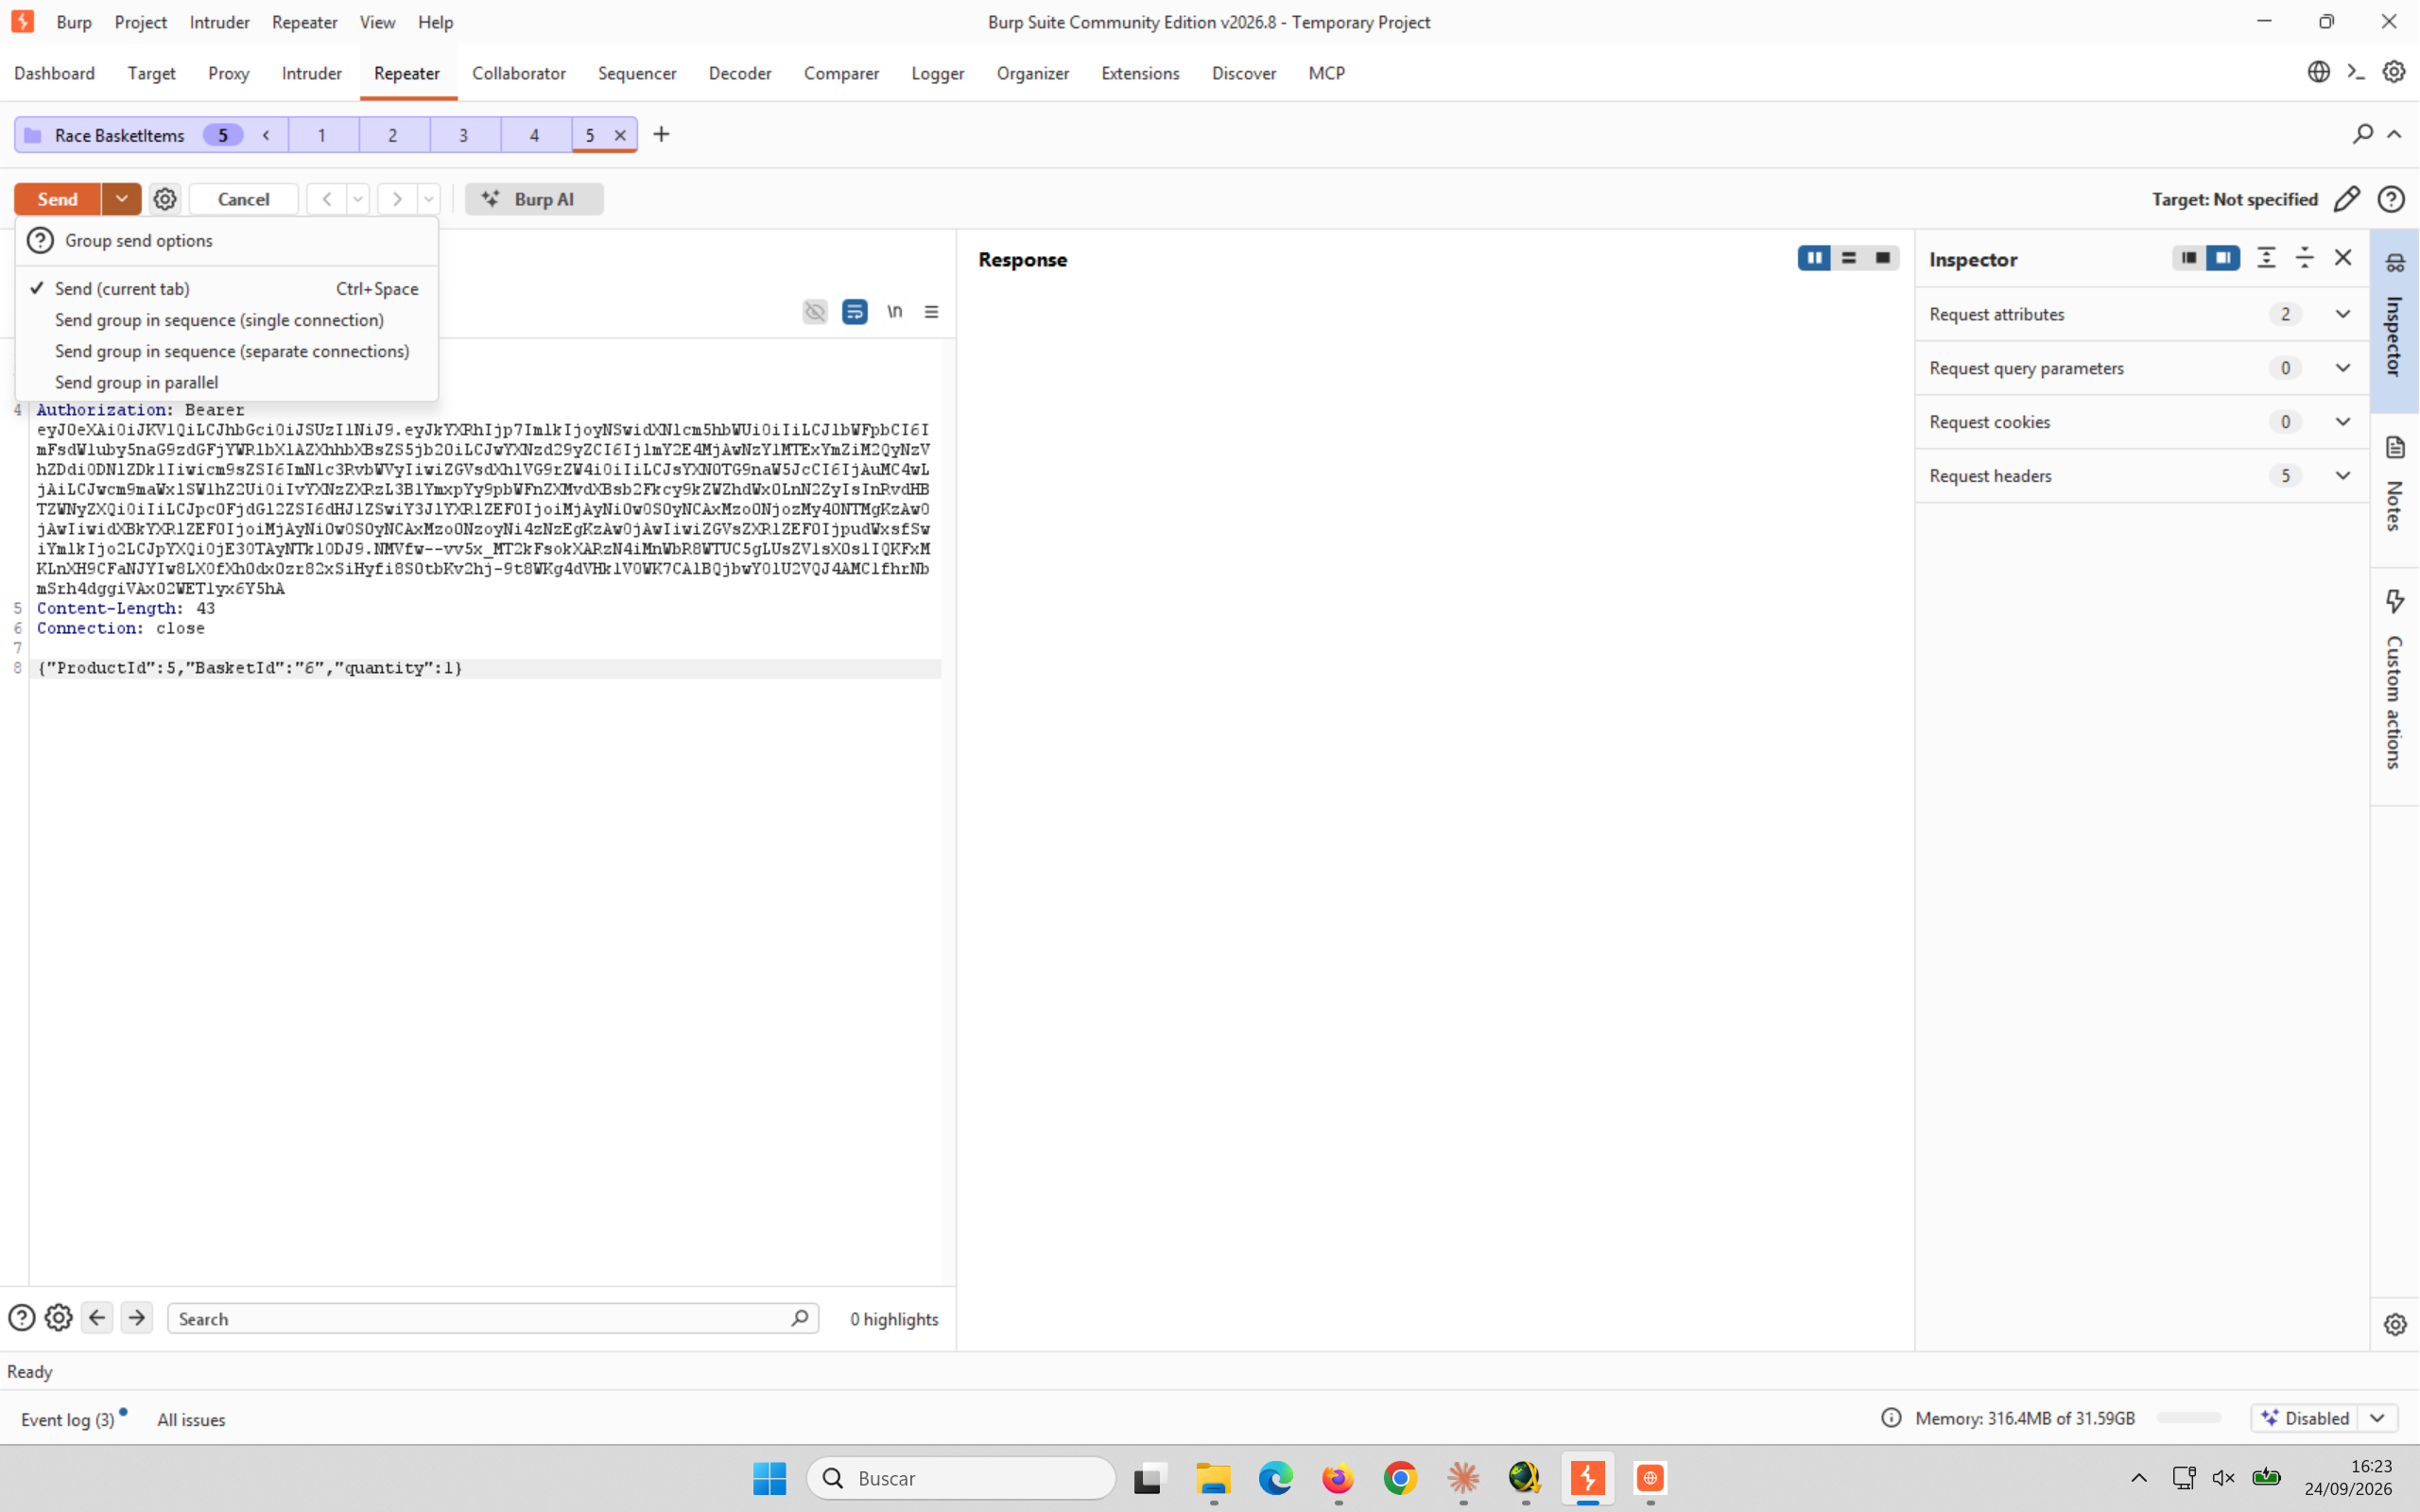
Repeater → agrupar pestañas → "Send group in parallel", junto a las variantes en secuencia
Por qué "en paralelo" no es solo mandarlas rápido
Mandar varias peticiones una detrás de otra desde un script normal todavía deja que la primera termine de procesarse antes de que llegue la segunda, la mayoría de las veces. La opción de Burp retrasa el envío de todas las peticiones del grupo hasta el último instante posible y las dispara juntas, para que lleguen al servidor lo más cerca posible unas de otras -la única forma realista de abrir esa ventana de milisegundos.
3. Primera prueba: registrar la misma cuenta a la vez
El candidato más intuitivo: si el registro comprueba "¿existe ya este email?" y luego "crea la cuenta" en dos pasos separados, diez peticiones simultáneas con el mismo email podrían colar más de una cuenta con el mismo correo. Se lanzan diez peticiones idénticas de golpe:
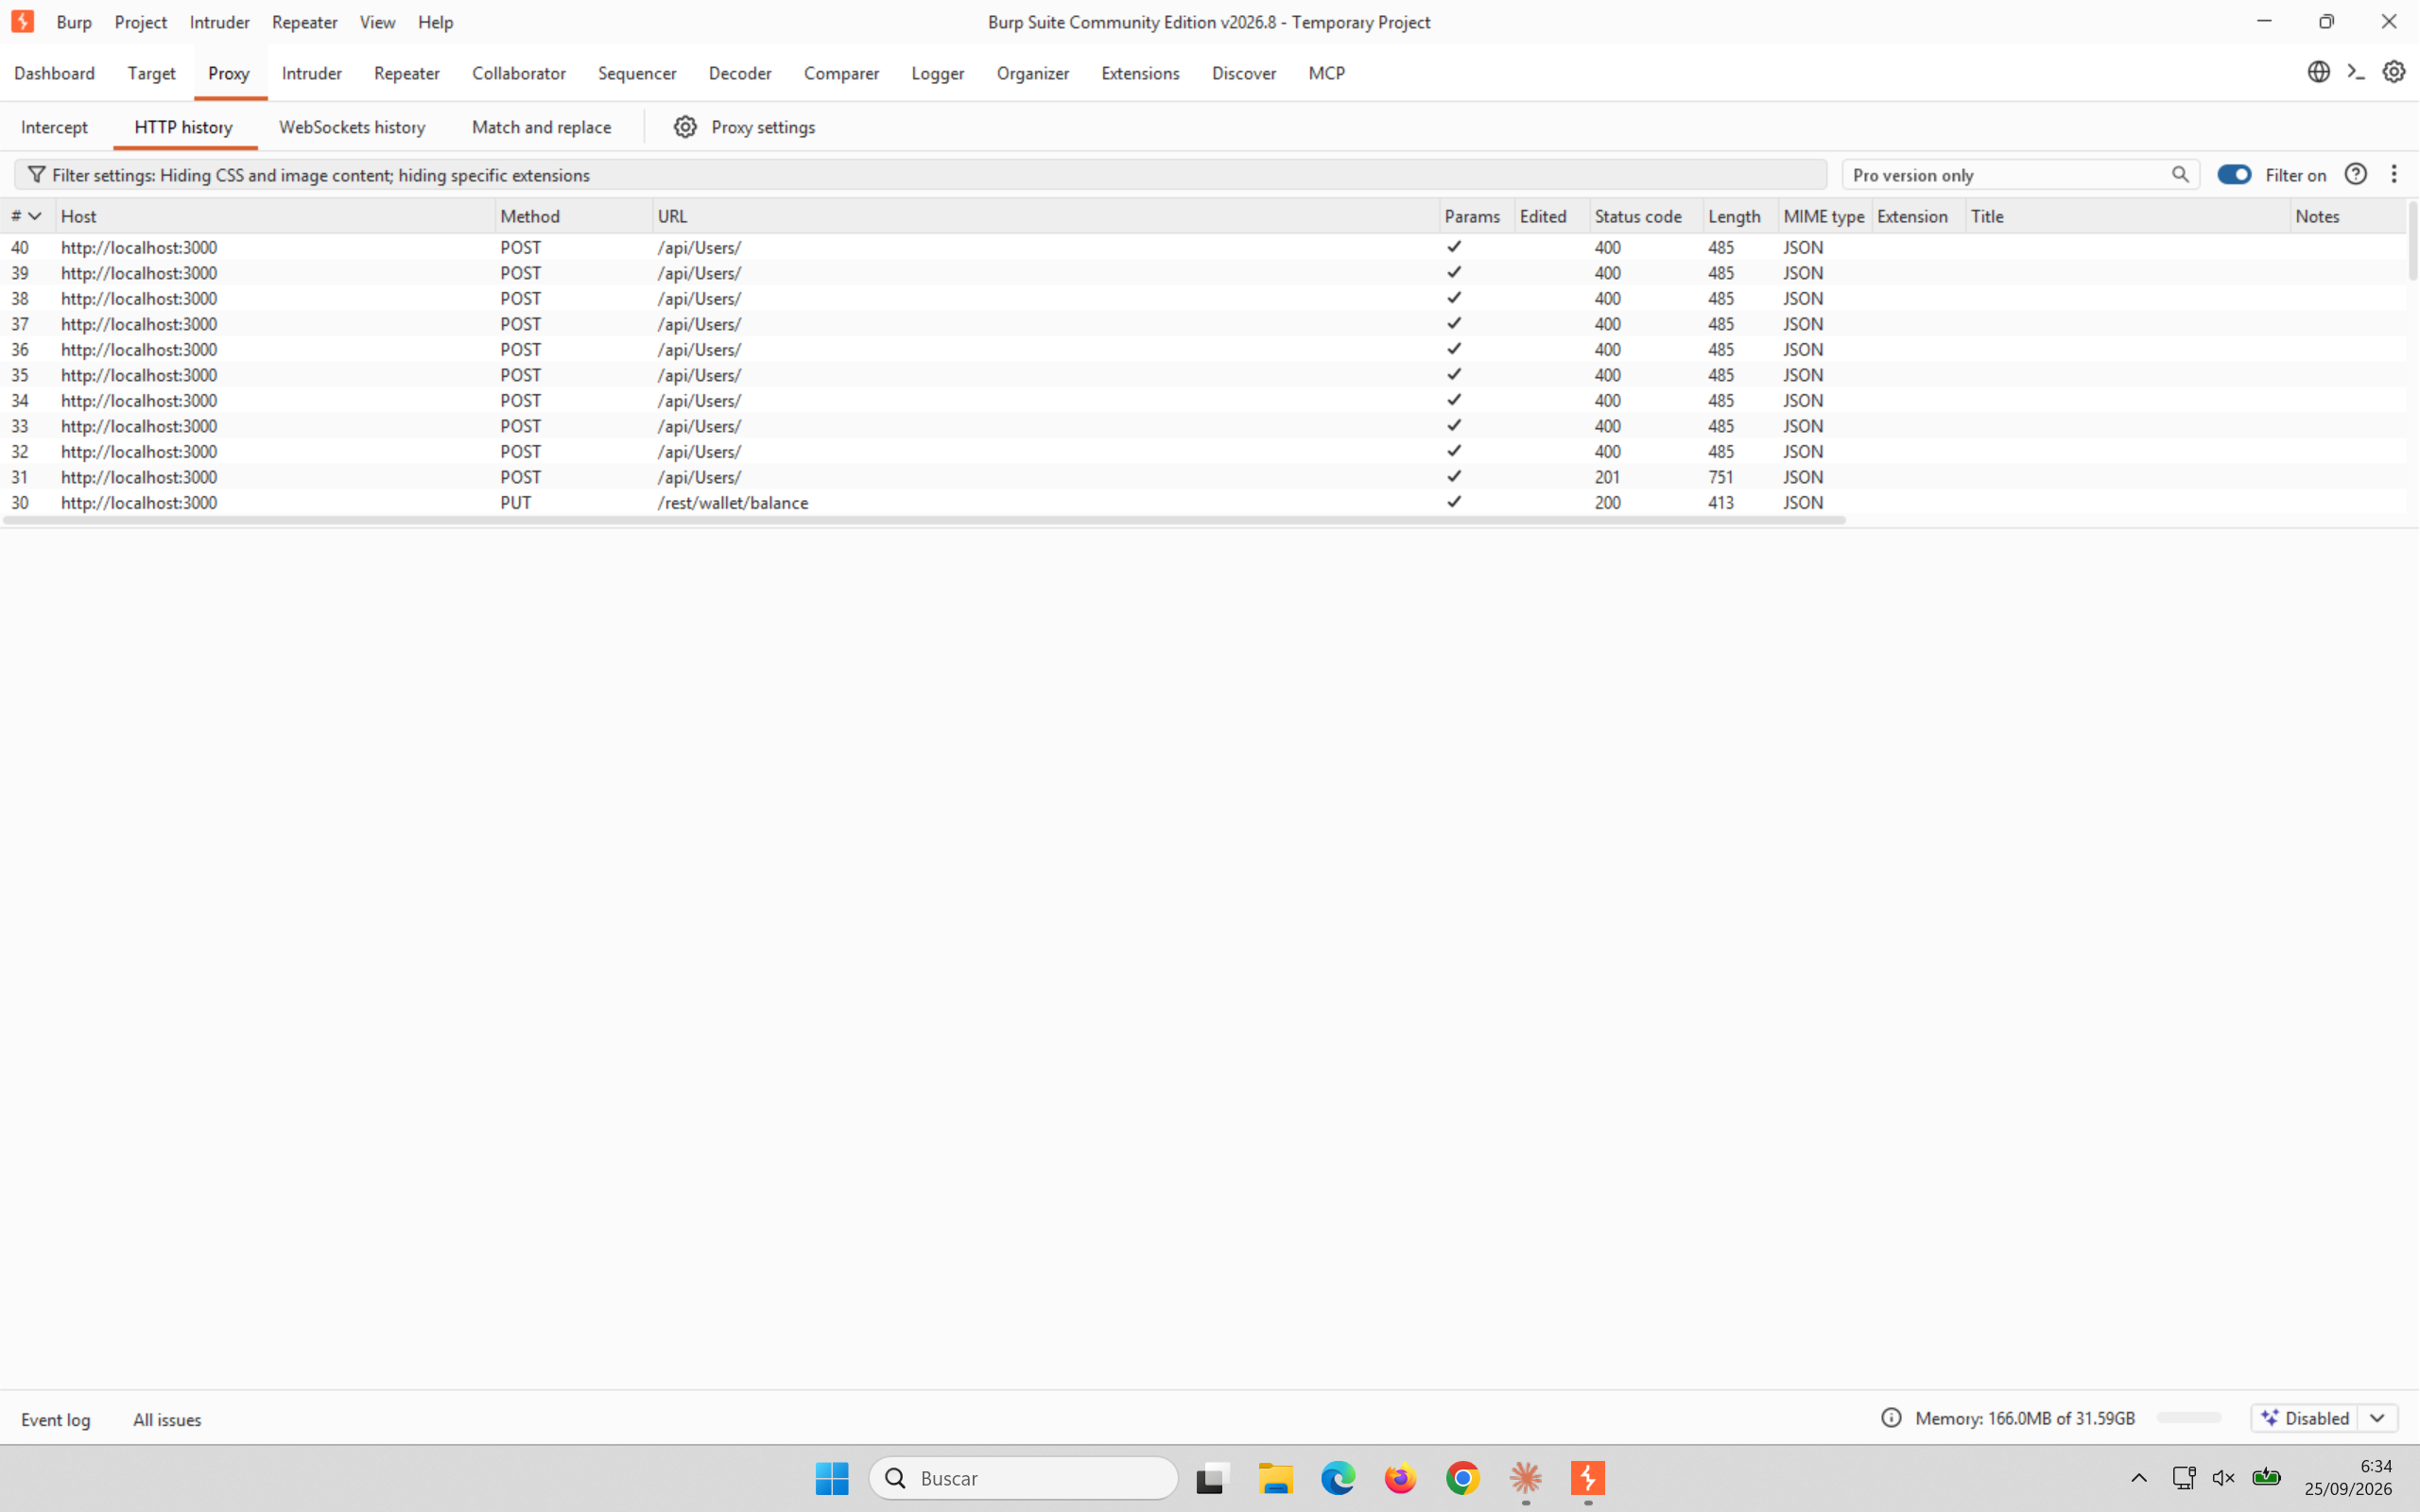
Diez POST /api/Users/ simultáneos con el mismo email: solo uno consigue 201, los otros nueve caen con 400
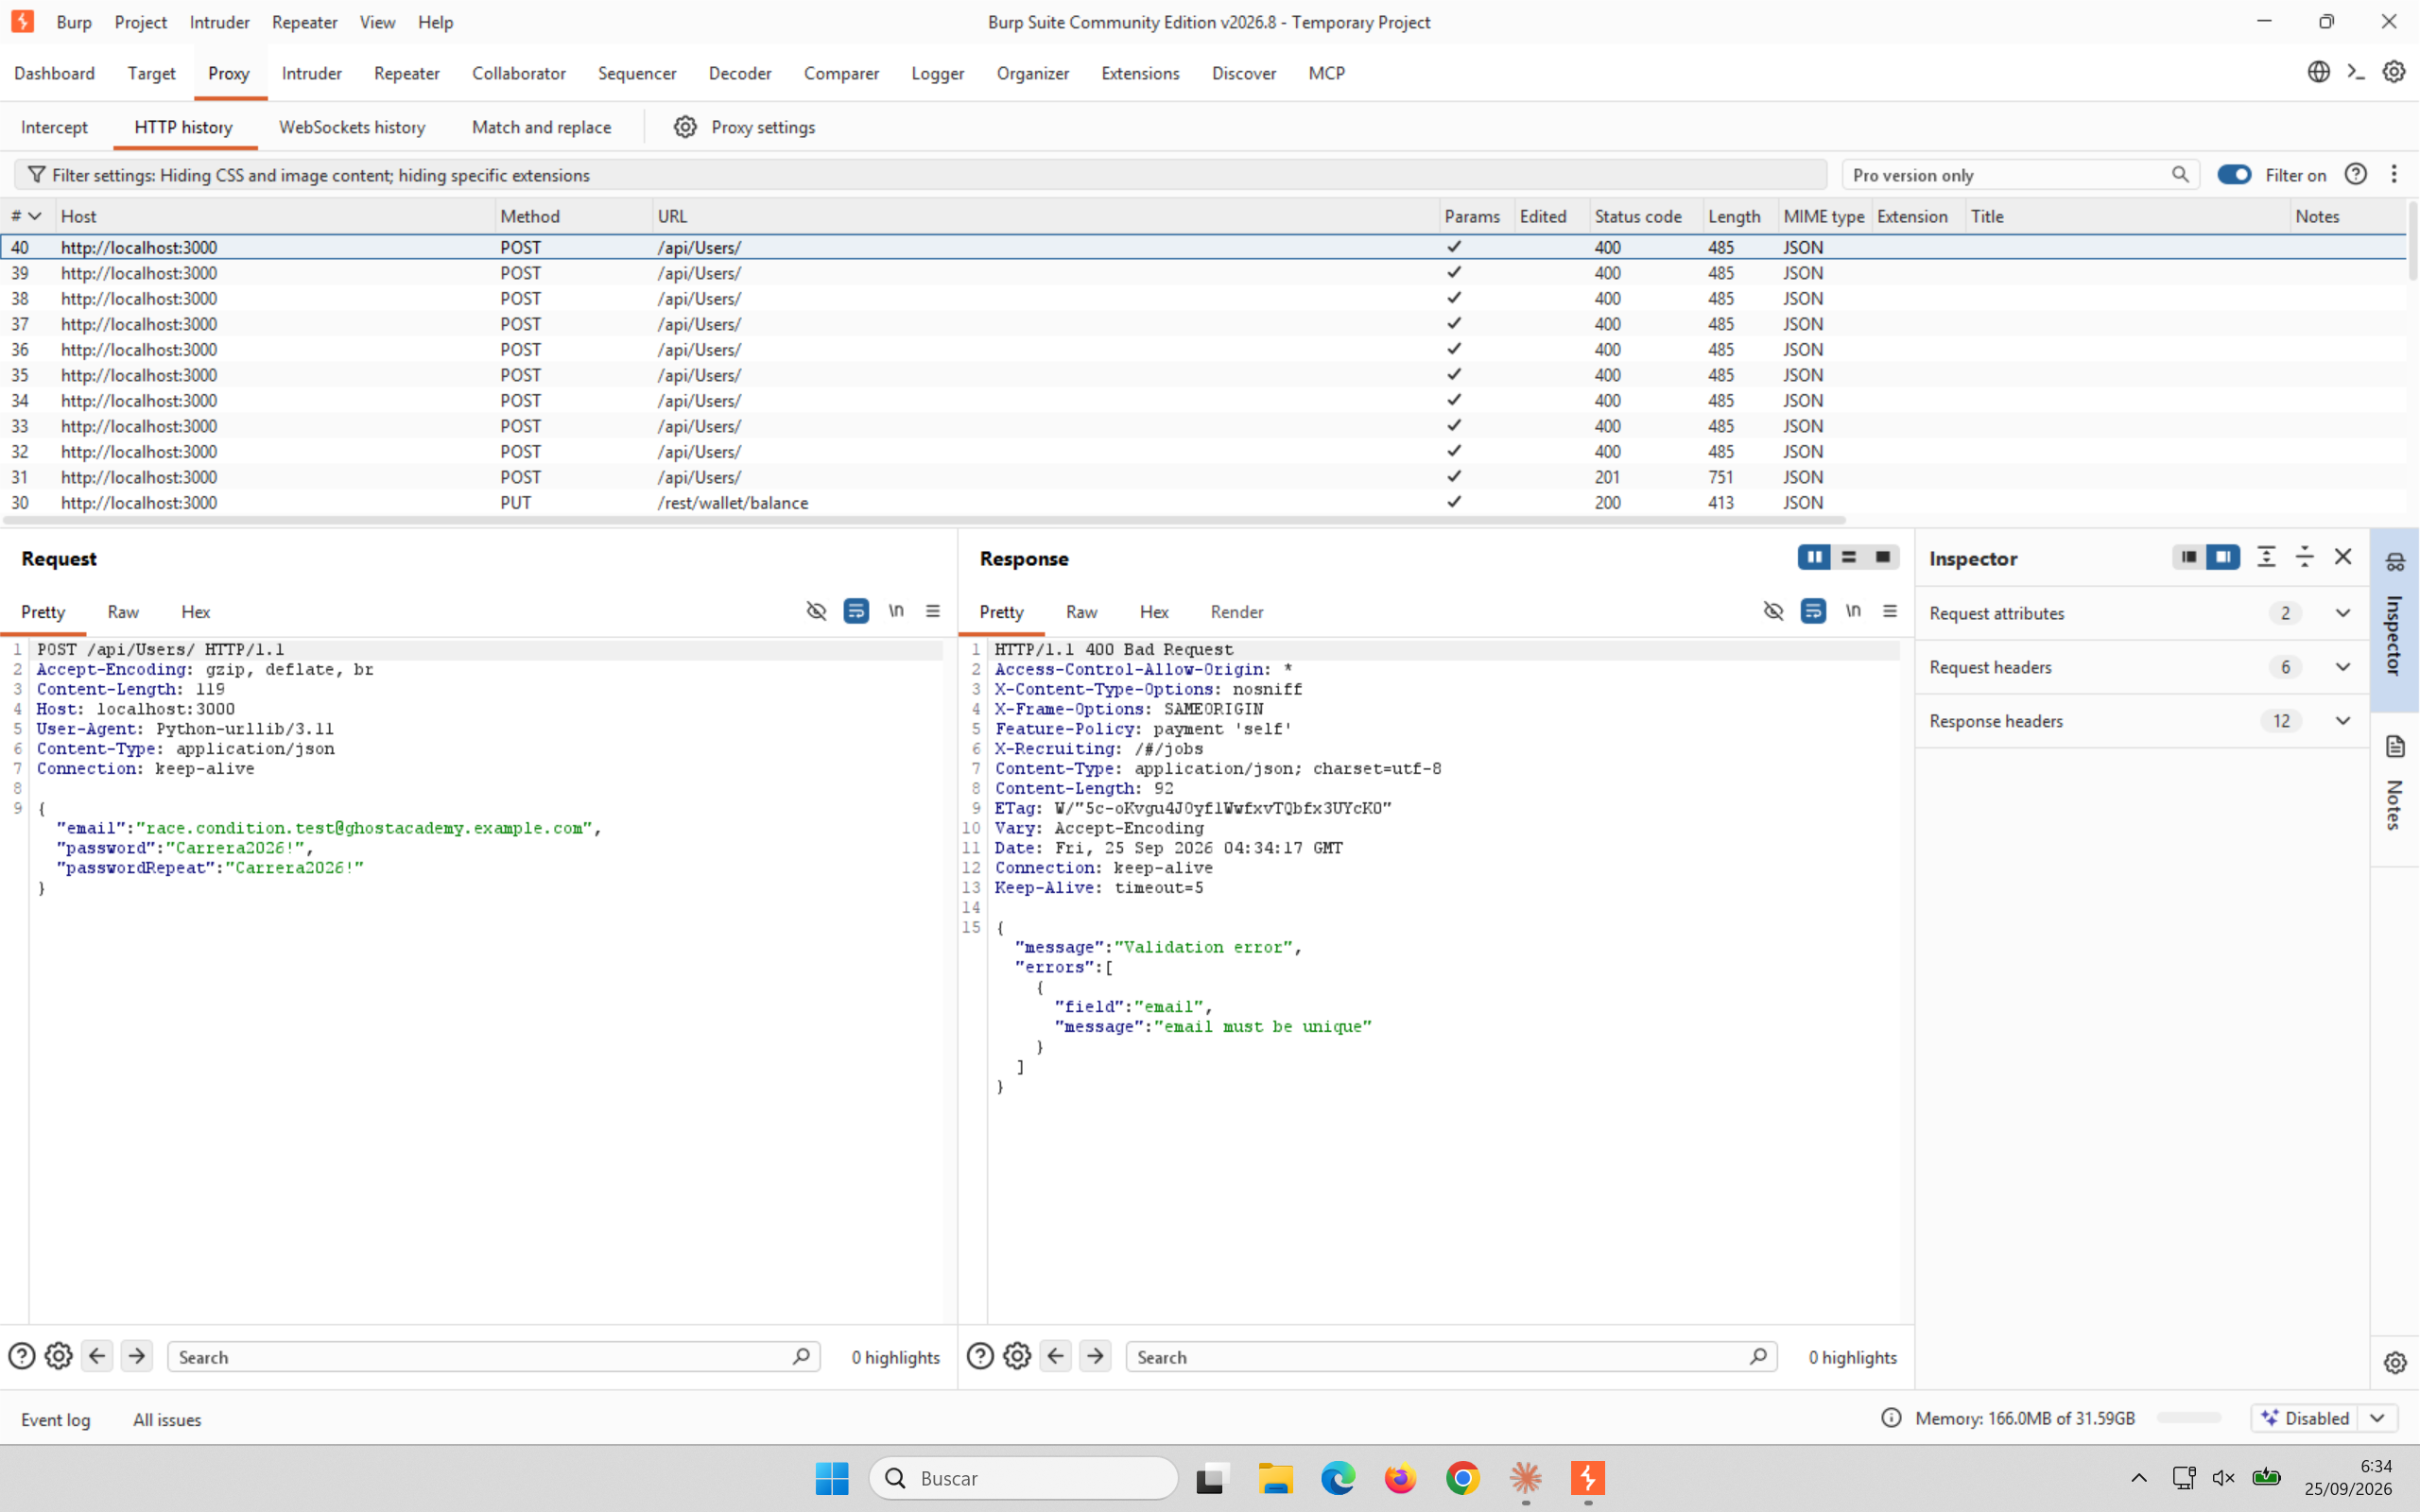
El motivo del bloqueo, en el propio cuerpo de la respuesta: "email must be unique"
Por qué esto SÍ aguanta la concurrencia
La protección no está en el código de la aplicación -que sí podría tener un hueco entre comprobar y crear- sino en la propia base de datos: una restricción `UNIQUE` sobre la columna email. Ese tipo de restricción la aplica el motor de base de datos de forma atómica, sin importar cuántas peticiones lleguen a la vez ni en qué orden -es exactamente el tipo de protección que una race condition no puede saltarse, porque no depende de ningún código de aplicación que pueda tener un hueco de tiempo.
El mismo patrón, repetido contra `POST /api/BasketItems/` con el mismo producto y el mismo carrito -otra restricción `UNIQUE`, esta vez sobre la pareja (ProductId, BasketId)- dio el mismo resultado: una sola fila creada, nueve peticiones rechazadas con un error de restricción de base de datos. Dos objetivos distintos, la misma defensa eficaz.
4. Cuando lo que parece una race condition no lo es
El monedero (capítulo 15) parecía el candidato perfecto para lo contrario: un saldo que se actualiza sumando una cantidad, sin ninguna restricción de base de datos que lo proteja. Diez depósitos simultáneos de 10€ cada uno deberían dejar un saldo final de 100€ si todo se procesa bien -o bastante menos si hay una actualización perdida por el camino.
El resultado, a primera vista, parecía justo eso: las diez peticiones devolvieron `"data":10` -el mismo valor, ni rastro de una suma acumulada. La conclusión rápida sería "actualización perdida, race condition confirmada". Pero antes de darla por buena, hace falta la misma prueba que se pediría a cualquier otro hallazgo: repetirla SIN concurrencia, una petición detrás de otra, y comprobar que el comportamiento cambia.
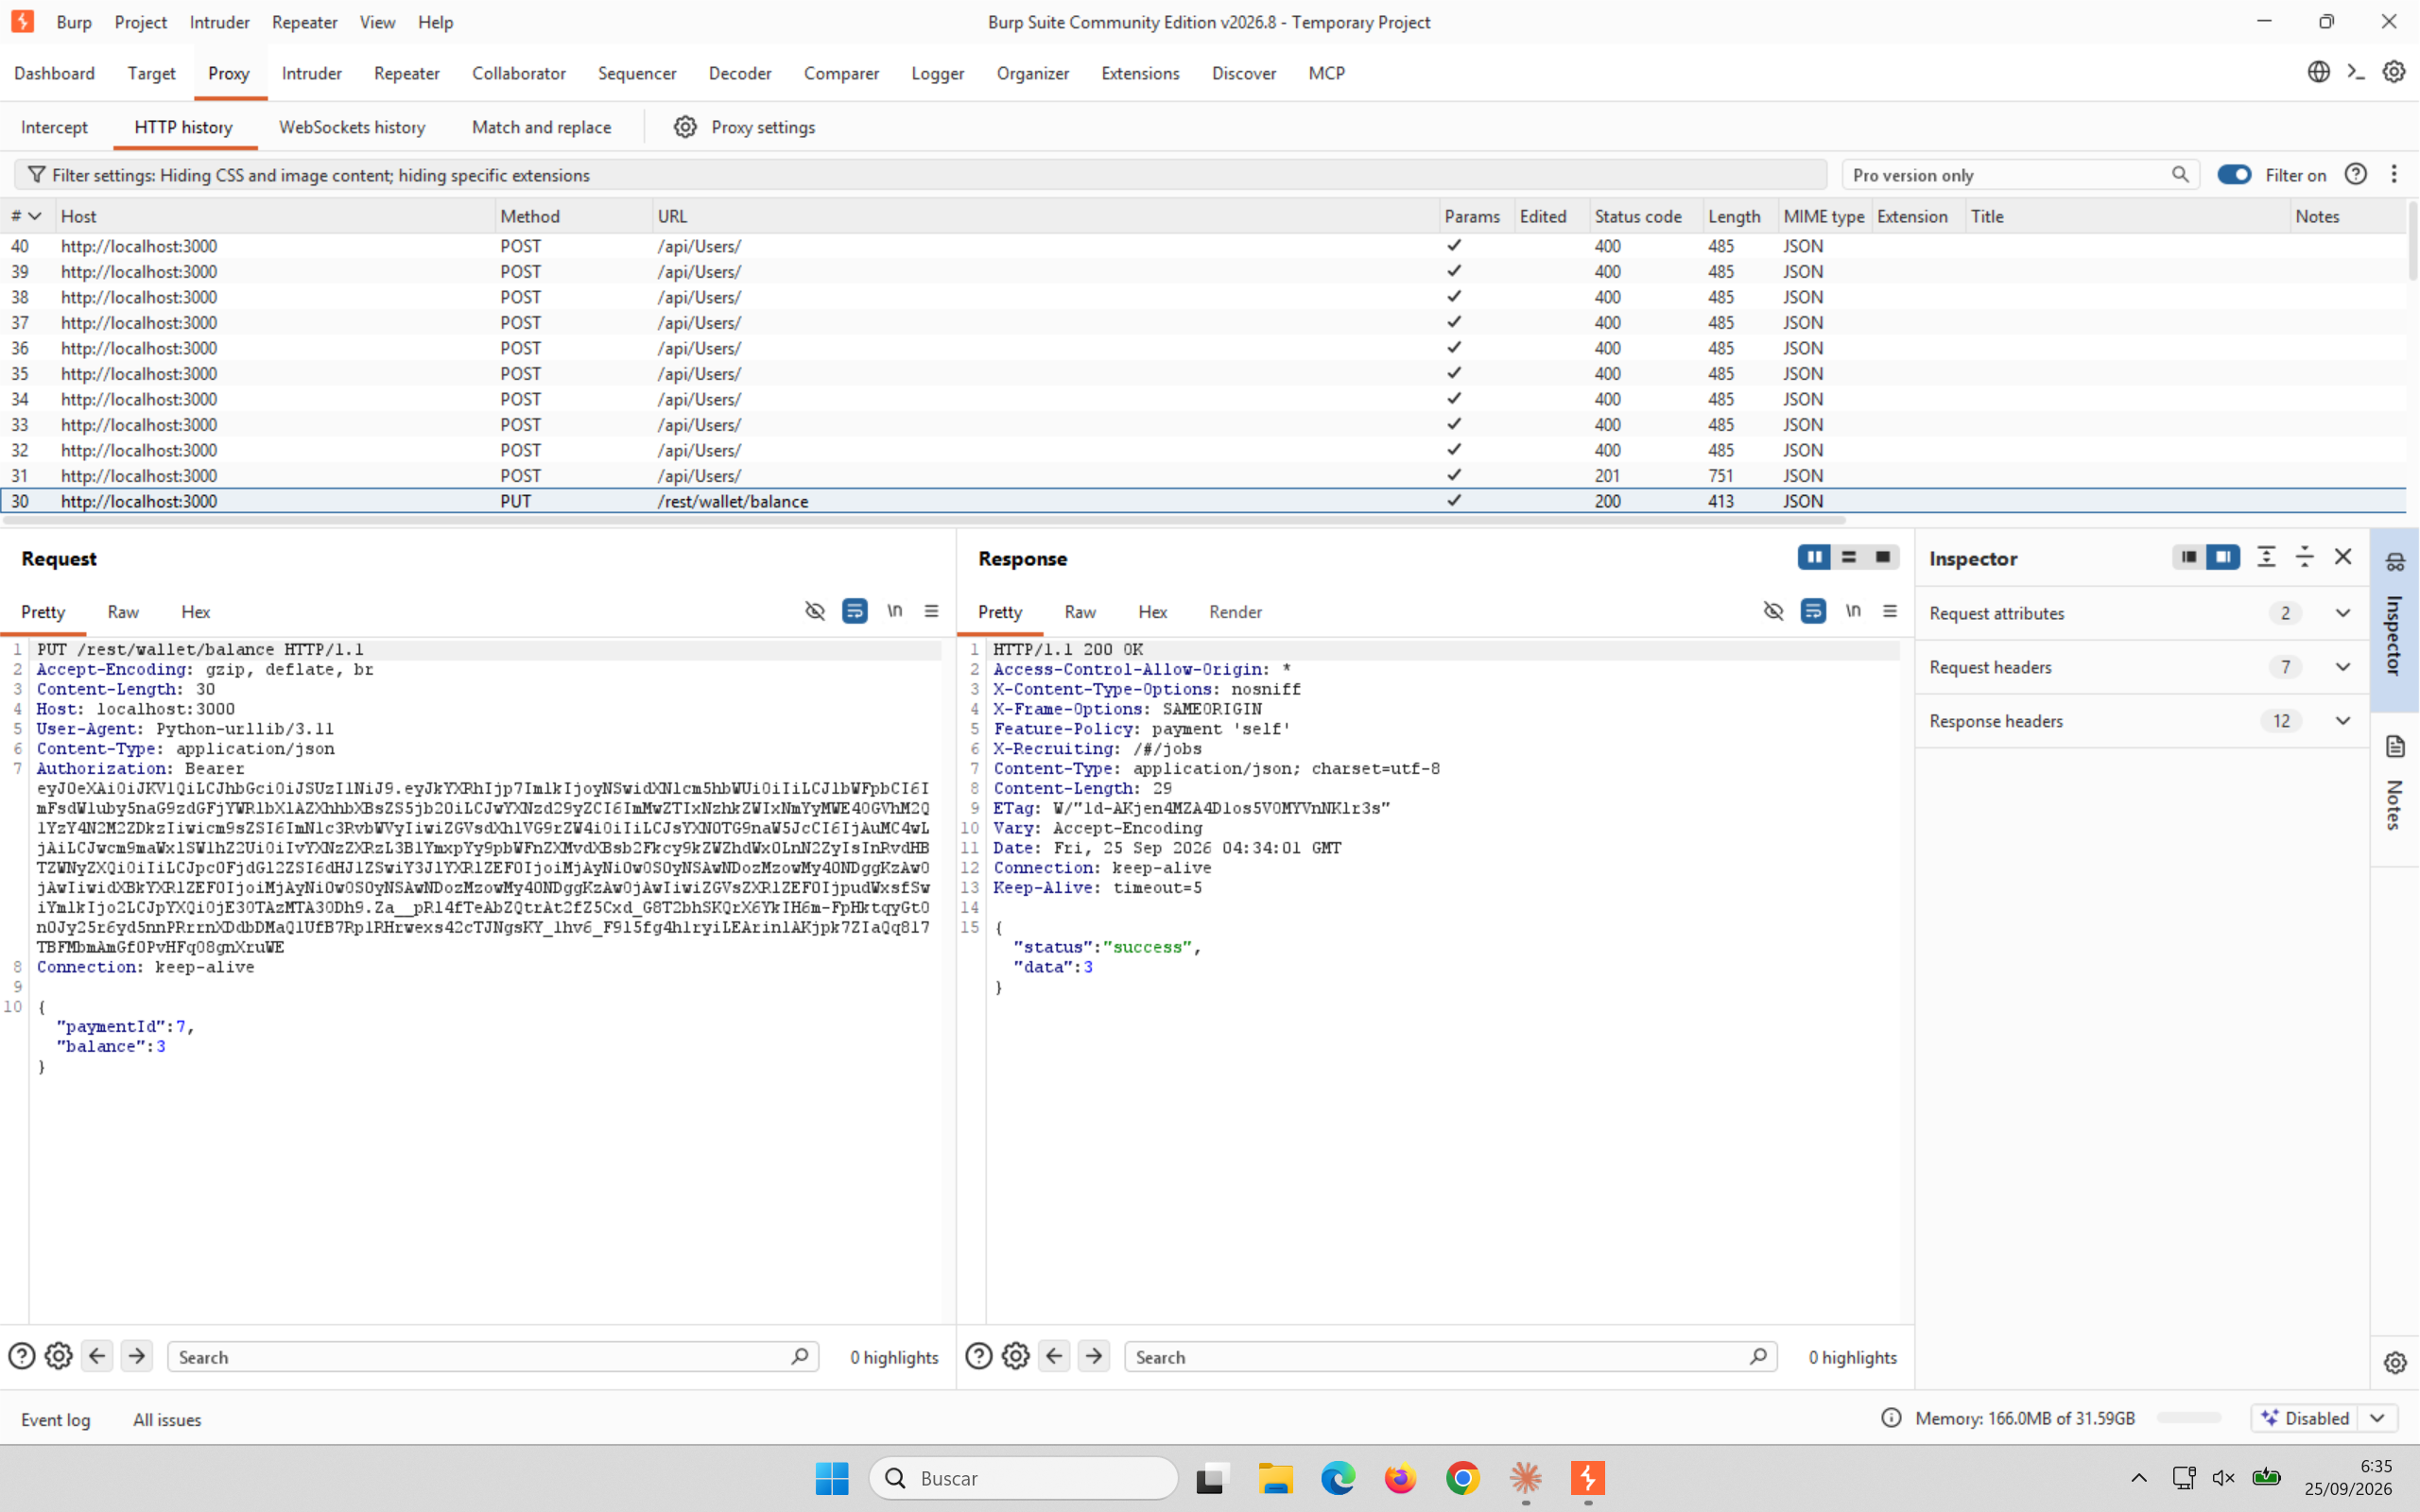
Una única petición PUT /rest/wallet/balance con "balance":3 -y la respuesta devuelve exactamente "data":3
La prueba de control desmontó el hallazgo -y eso es bueno
Repetido en secuencia, cada depósito de 10€ seguía devolviendo 10, nunca una suma acumulada -y aquí, con "balance":3, la respuesta es 3. El endpoint no suma nada: FIJA el saldo al valor exacto que manda el cliente cada vez, sin memoria del valor anterior. No hay hueco de tiempo que explotar porque no hay una operación de lectura-suma-escritura en absoluto -es un fallo de diseño distinto (el capítulo 15 ya lo señaló: cualquiera puede poner su saldo al valor que quiera), pero no es una race condition. Confundir los dos habría sido reportar algo que no es lo que parece.
Conclusión
Tres pruebas, una técnica -agrupar peticiones idénticas y dispararlas a la vez con Burp- y dos veredictos distintos: dos restricciones de base de datos que aguantaron perfectamente la concurrencia real, y un tercer candidato que parecía una race condition hasta que una prueba de control con una sola petición secuencial reveló que el problema era otro completamente distinto. La lección no es solo cómo lanzar el ataque -es no dar un hallazgo por bueno sin la prueba de control que lo confirme.
El capítulo siguiente entra en el terreno más clásico de todos -inyección SQL, NoSQL, de comandos, y XSS- con la misma exigencia: cada payload que funcione hay que poder explicarlo, no solo lanzarlo.
unfantasmaenelsistema.com | Seguridad, sistemas y todo lo que no debería funcionar (pero funciona)