Manual de Burp Suite Community Edition
Capítulo 9 · Decoder, Comparer y Sequencer
Serie: Burp Suite desde cero | unfantasmaenelsistema.com
Cerramos el bloque de herramientas activas con tres piezas más pequeñas que Repeater o Intruder, pero que resuelven preguntas muy concretas: Decoder transforma datos codificados en algo legible, Comparer encuentra la diferencia exacta entre dos respuestas, y Sequencer mide si un token es realmente aleatorio o solo lo parece.
Qué aprenderás en este capítulo
Cómo decodificar un JWT real y qué información puede filtrar sin que nadie lo note · Cómo comparar dos respuestas byte a byte y ver exactamente qué cambió · Cómo pedirle a Sequencer un veredicto estadístico sobre la calidad de un token · Por qué medir la aleatoriedad de un token completo puede dar un resultado engañoso si no se aísla la parte que importa
1. Decoder: lo que un JWT revela sin cifrar nada
Un JWT (JSON Web Token) tiene tres partes separadas por puntos -cabecera, payload y firma- y las dos primeras están codificadas en Base64, no cifradas. Cualquiera que lo intercepte puede leer su contenido sin ninguna clave. Pegando el payload del token de nuestra propia cuenta de prueba en Decoder y seleccionando Decode as → Base64, aparece el JSON completo:
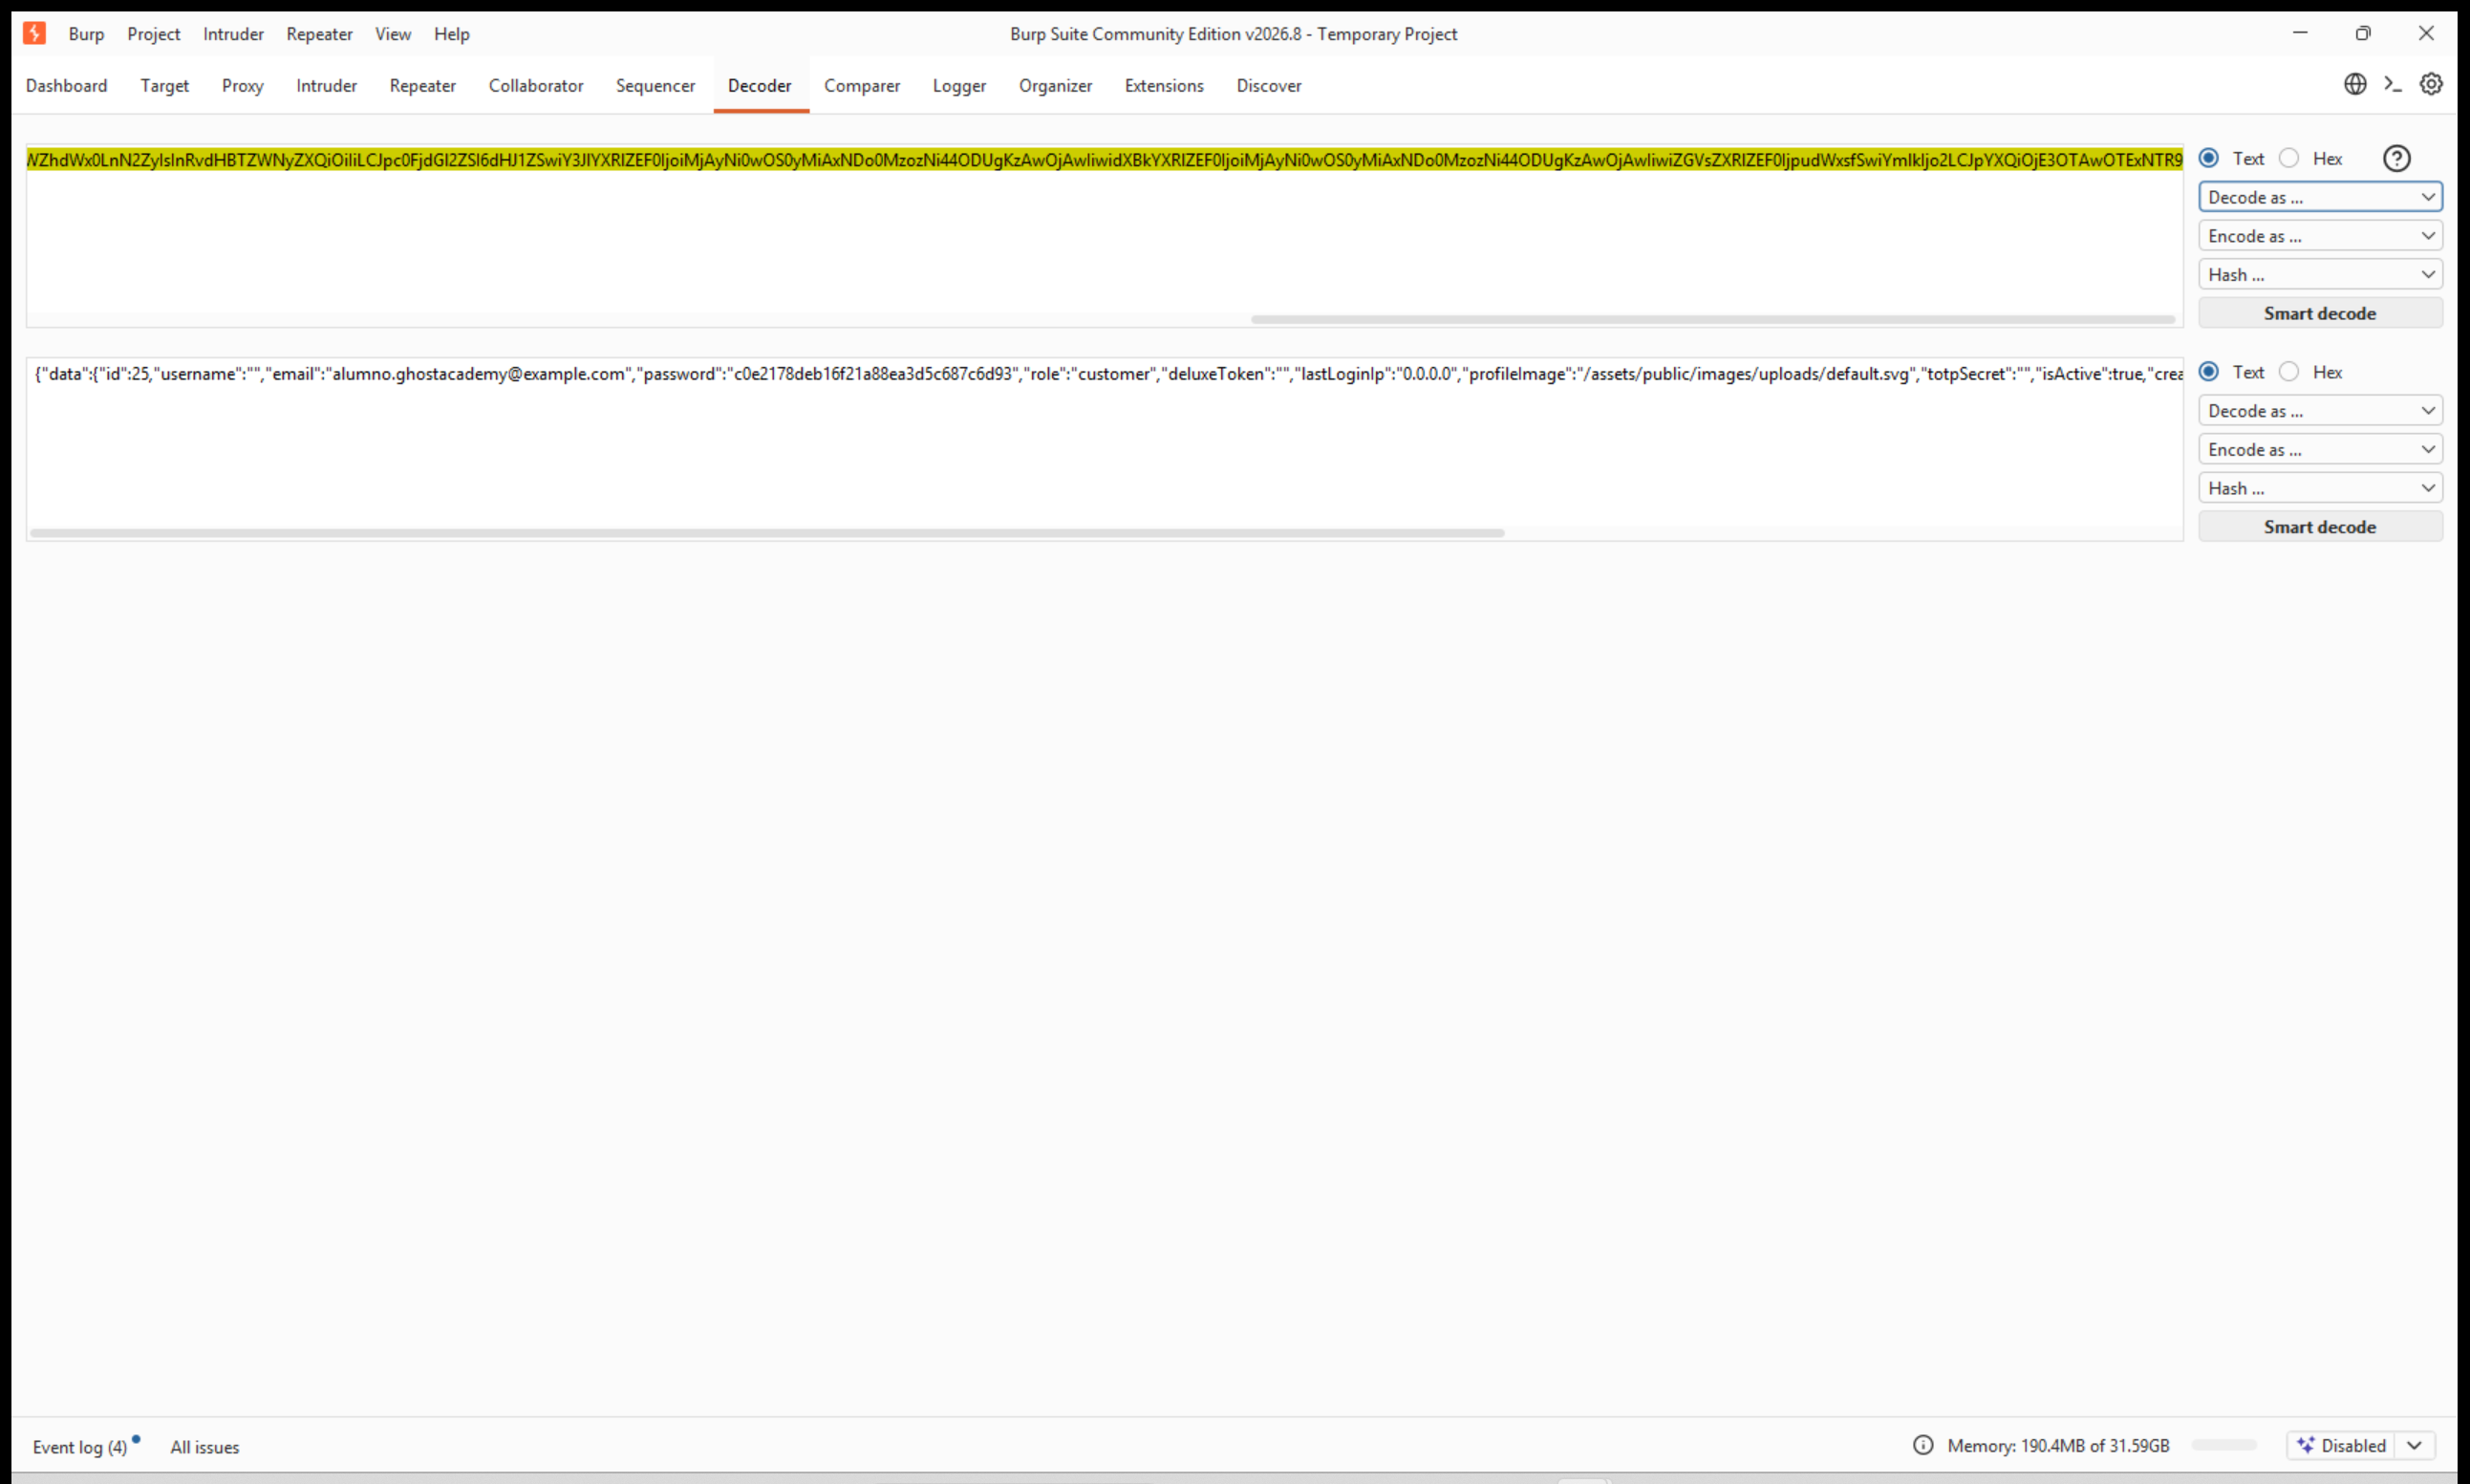
El payload del JWT de Juice Shop, decodificado: incluye el email, el rol... y un campo "password" con un hash
Un hallazgo real, no un ejemplo inventado
Ese "password":"c0e2178deb16f21a88ea3d5c687c6d93" es el hash MD5 de la contraseña de la cuenta, viajando dentro del propio token en cada petición autenticada. No hace falta ni Repeater ni ningún ataque: basta con decodificar Base64 -algo que cualquiera con Burp hace en diez segundos- para tener ese hash en las manos. Es exactamente el tipo de fuga de datos que decodificar sistemáticamente cualquier token que veas en el tráfico puede sacar a la luz.
Decoder trabaja en cadena: el resultado de una decodificación se puede volver a decodificar o codificar en el paso siguiente (URL, HTML, Base64, ASCII hex, Hex, Octal, Binario, Gzip), y Smart decode intenta adivinar automáticamente las capas de codificación aplicadas. Para tokens estructurados como un JWT, seleccionar manualmente el tramo exacto (header, payload o firma) y elegir Base64 a mano, como en el ejemplo, da un resultado más limpio que confiar en el modo automático.
2. Comparer: la diferencia exacta entre dos respuestas
Comparer recibe dos textos -pegados, cargados desde archivo, o enviados desde cualquier otra pestaña con "Send to Comparer"- y resalta palabra por palabra o byte por byte qué cambió entre uno y otro. El siguiente ejemplo compara la respuesta de buscar "apple" contra la de buscar "banana" en el catálogo:
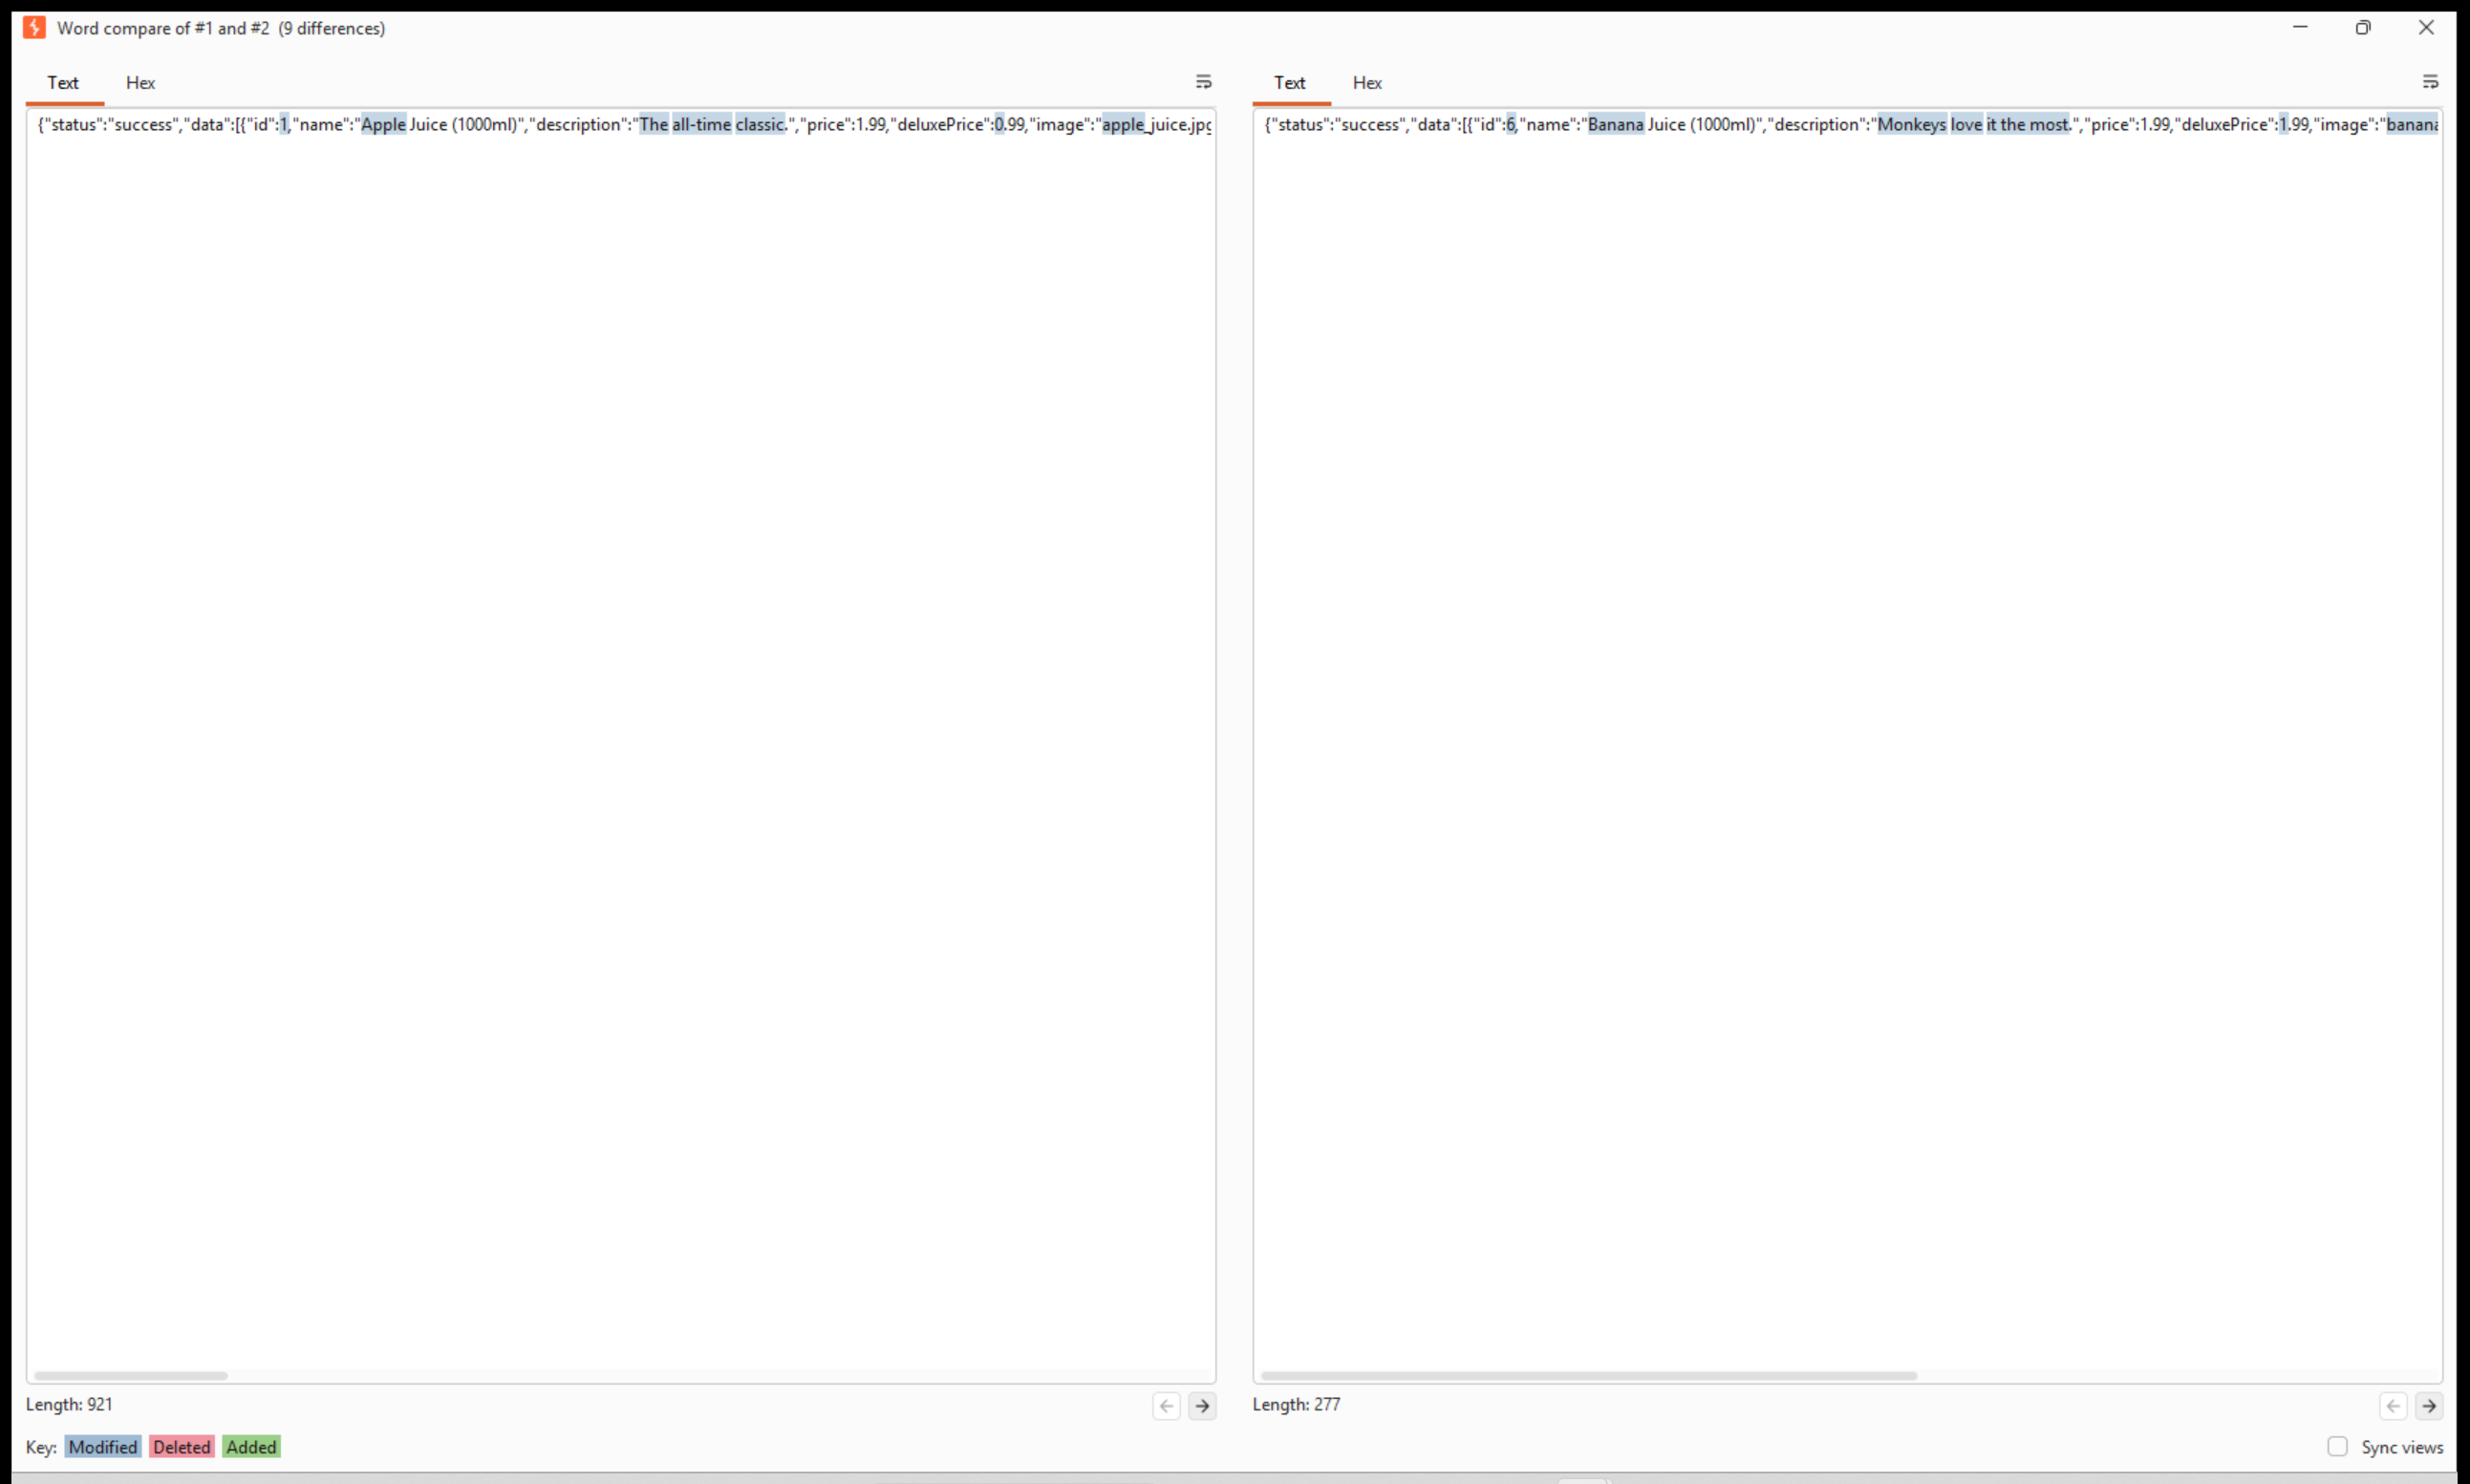
Comparación por palabras: 9 diferencias resaltadas, longitudes 921 frente a 277 -la respuesta de "apple" trae más resultados-
El caso de uso más habitual no es comparar dos búsquedas -aquí solo para ilustrar la mecánica-, sino comparar la misma petición repetida con un solo cambio: la respuesta con tu propia sesión frente a la respuesta con la sesión de otra cuenta de prueba, o la respuesta "antes" y "después" de cambiar un parámetro en Repeater. Cuando la diferencia esperada es sutil -una palabra, un número, una cabecera- Comparer la encuentra en un vistazo donde leer las dos respuestas enteras a mano sería lento y propenso a errores.
3. Sequencer: ¿es aleatorio de verdad este token?
Sequencer aplica una batería de pruebas estadísticas a una muestra de tokens -de sesión, de recuperación de contraseña, anti-CSRF- y da un veredicto sobre cuánta entropía real contienen. Se puede alimentar en vivo (Live capture, reenviando una petición de login muchas veces) o con una muestra ya recogida (Manual load, pegando una lista). Community Edition exige un mínimo de 100 tokens para arrancar el análisis.
Con 117 copias reales del JWT de nuestra cuenta de prueba -obtenidas repitiendo el login- el veredicto de Sequencer fue contundente:
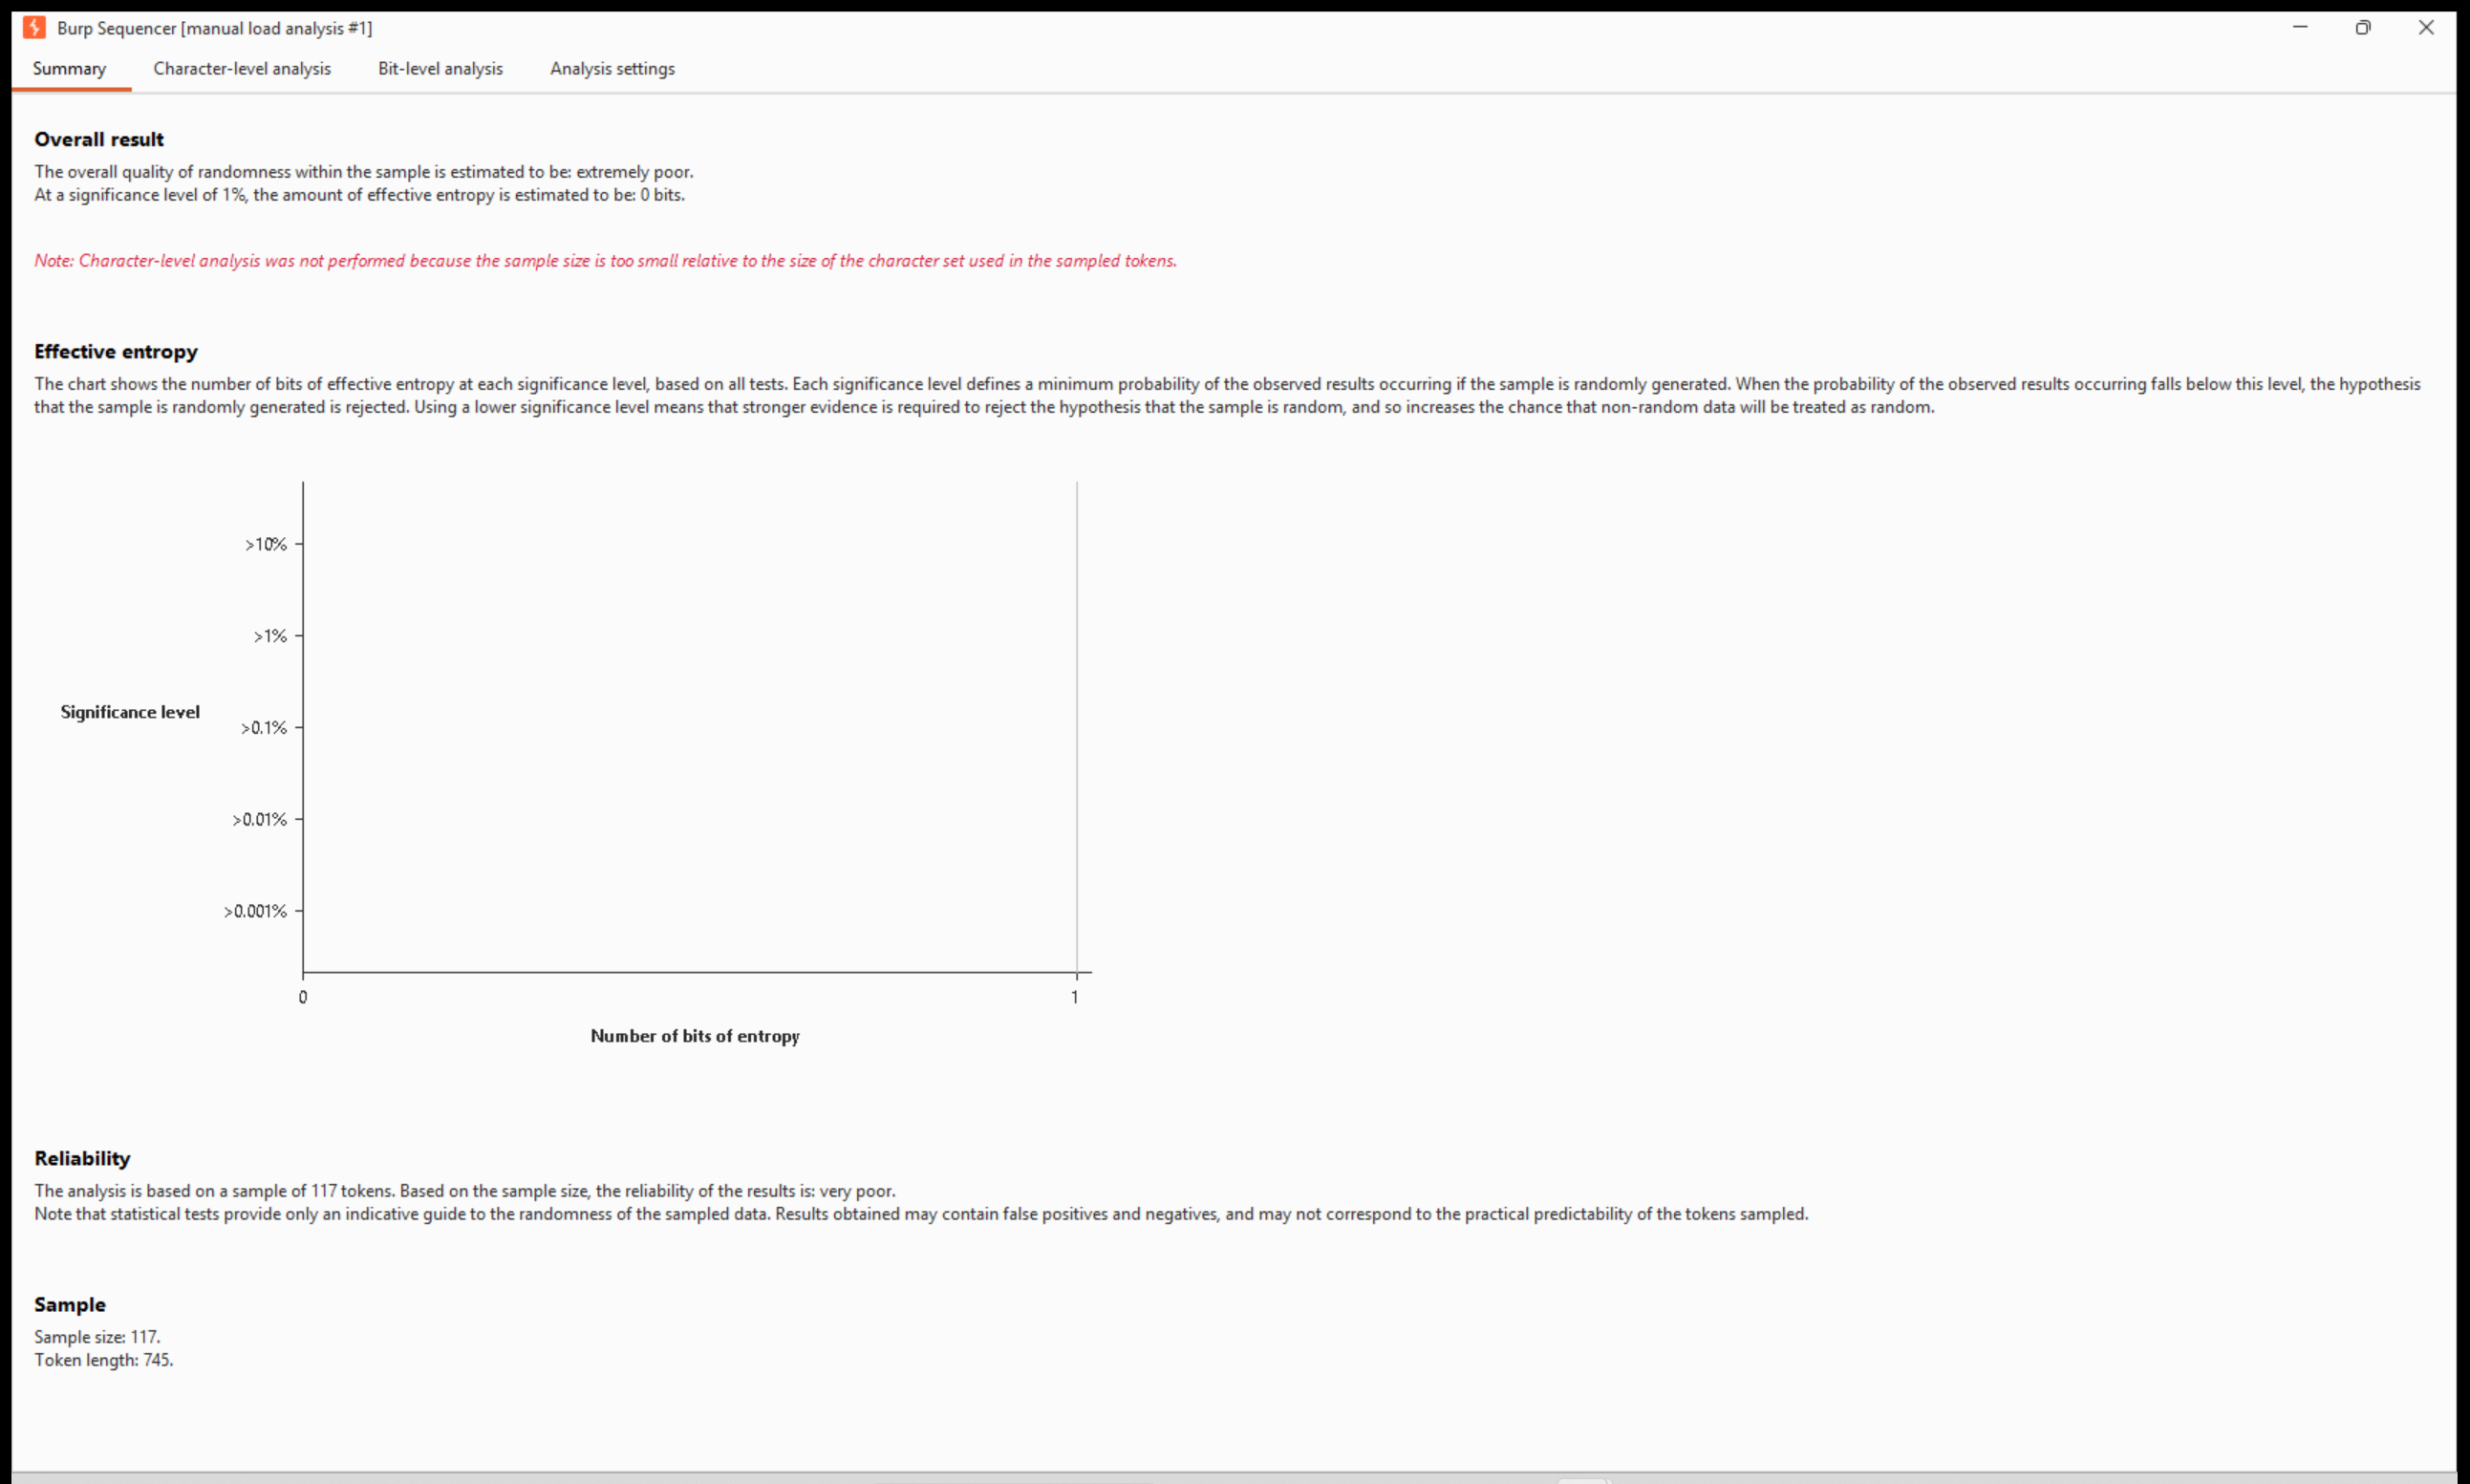
"The overall quality of randomness within the sample is estimated to be: extremely poor. […] 0 bits" de entropía efectiva
Por qué este resultado es engañoso -y la lección real que deja
Un JWT firmado con RS256 no es un token débil: la firma en sí es criptográficamente robusta. Lo que Sequencer detectó aquí es que analizó las 745 posiciones del token completo, y salvo la firma (unos 150 caracteres al final) y la fecha "iat" del payload, el resto -cabecera, email, rol, estructura JSON- es idéntico en cada copia. Esa parte fija, mucho más larga que la parte aleatoria, diluye el resultado a "0 bits". La lección práctica: para medir la aleatoriedad de un token con partes estructuradas, hay que aislar solo el fragmento que debería ser aleatorio -aquí, la firma- en vez de pasarle el token entero, o el resultado global no significa lo que parece decir.
Donde Sequencer da su resultado más útil sin este matiz es en tokens que son enteramente el valor aleatorio -una cookie de sesión que es solo un identificador, un token de "recordarme", un código de recuperación de contraseña corto-, sin cabecera ni estructura fija alrededor mezclada en el análisis.
Conclusión
Con Decoder, Comparer y Sequencer se cierra el bloque de herramientas activas: transformar datos, diferenciar respuestas y medir aleatoriedad son las tres operaciones de apoyo que aparecen una y otra vez al investigar cualquier hipótesis real.
El último capítulo de este bloque recorre las extensiones de la BApp Store que más aportan sobre la base de Community Edition, antes de entrar de lleno, en el bloque siguiente, en casos de uso completos por funcionalidad: carritos, cuestionarios, direcciones y APIs.
unfantasmaenelsistema.com | Seguridad, sistemas y todo lo que no debería funcionar (pero funciona)